谷歌开源 Harness² 框架:无需修改模型权重,实现 AI 运行时自我改进
谷歌近日开源了递归自我改进(RSI)领域的 Harness² 框架。该框架通过优化大模型外围的运行脚手架(Scaffold),在不修改模型底层权重的情况下,提升 AI 在实际任务中的表现,为大模型和智能体(Agent)的持续改进提供了新的技术路径。
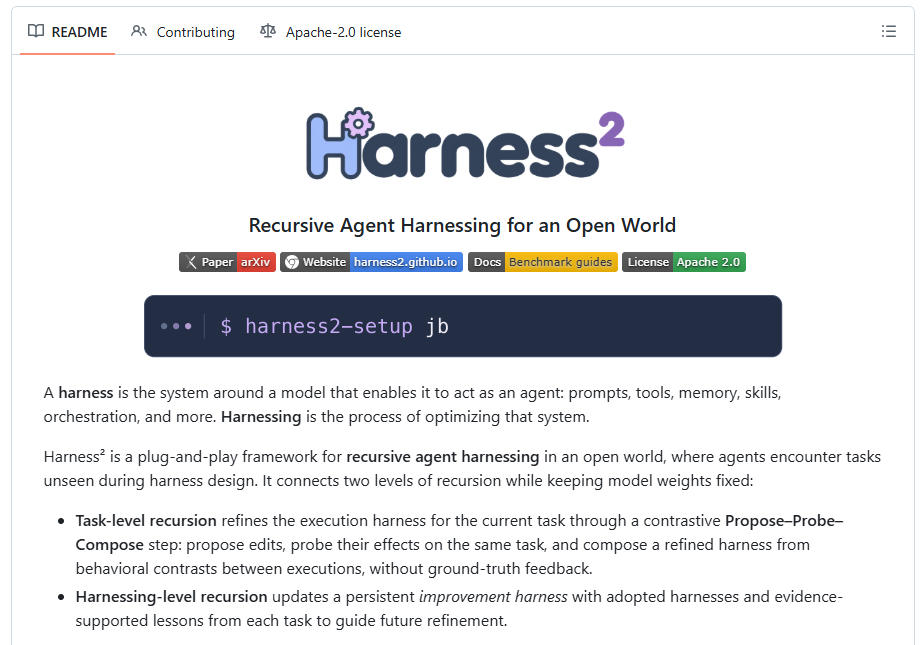
与传统依赖增加模型参数、提升算力或重新训练模型的优化方式不同,Harness² 将重点放在模型运行过程中的策略、工具调用及任务执行机制上。通过持续积累和复用改进经验,该框架旨在帮助 AI 系统在完成任务的过程中发现问题、修正不足,并将有效的改进应用于后续任务。
一、双层递归架构:解决自我改进中的两大难题
递归自我改进(Recursive Self-Improvement,RSI)是指 AI 系统利用自身的运行结果和反馈,不断优化后续表现的技术方向。不过,传统 RSI 方案在实际应用中仍面临一些挑战,例如缺乏标准答案时难以准确判断改进是否有效,以及容易针对单次任务过度优化,影响后续任务的表现。
针对这些问题,Harness² 引入了任务级递归与改进级递归相结合的双层架构。
任务级递归:通过提议、探测与合成验证改动
在缺乏标准答案的开放式任务中,系统通过提出改进方案、开展多步对照验证,并筛选有效的修改内容,将经过验证的改动合并到运行脚手架中。同时,该机制支持并行扩展,有助于扩大改进方案的搜索范围,提高发现有效策略的机会。
改进级递归:建立可持续复用的经验库
框架会将调试和任务执行过程中积累的有效经验保存到持续改进经验库中。当 Agent 面对新的任务时,可以检索并复用已有经验,减少重复探索,让此前获得的改进成果继续发挥作用。
通过这两层机制,Harness² 不仅关注单次任务能否完成,也尝试将任务中的有效经验转化为后续可复用的改进能力。
二、基准测试表现:多个领域的任务得分提升
根据原文披露的测试数据,Harness² 在多项基准测试中取得了积极表现。
在办公任务基准 WorkBuddy-Bench 测试中,接入 Harness² 框架后,GLM-5 的得分提升了 11.5 分,并超过了原生 Gemini 3.5 Flash 的测试成绩。
此外,在 JobBench、法律领域基准 LAB 等测试中,接入框架后的模型表现也有所提升。通过跨领域迁移和复用经验库中的有效策略,框架还能够进一步改善部分任务的执行效果。
这些测试结果表明,模型的实际任务表现不仅取决于底层权重和参数规模,外围运行机制、任务执行策略以及经验复用能力同样可能发挥重要作用。
需要注意的是,基准测试成绩会受到测试环境、任务设置和评估方法等因素影响,具体提升幅度仍应结合相应测试条件进行判断。
三、从模型参数扩展到 Runtime 认知工程
Harness² 的开源为 AI 系统优化提供了另一种思路:除了通过扩大模型规模和增加训练投入提升能力,还可以通过改进运行时机制,让 Agent 在执行任务的过程中不断积累经验、发现问题并优化自身的工作方式。
这一思路将优化重点从单纯的模型训练延伸到运行时(Runtime)层面。对于开发者而言,如果能够在不修改模型权重的情况下,通过优化外围脚手架提升任务表现,就有机会降低部分能力改进的成本,并提高既有模型在不同场景中的利用效率。
随着 Harness² 开源,开发者可以进一步探索递归自我改进机制在智能体开发、办公自动化、代码执行及专业领域任务中的应用。不过,框架的实际收益仍取决于任务类型、验证机制、经验质量和运行环境,不能简单理解为所有模型接入后都会获得相同幅度的性能提升。
总体来看,Harness² 展示了 Runtime 认知工程的一种探索方向:通过持续验证、积累和复用有效经验,让 AI 系统在实际运行中逐步改进,为智能体能力优化提供新的技术选择。

广告合作

QQ群号:4114653
- 本网站发布的内容(图片、视频和文字)以原创、转载和分享网络内容为主,如果涉及侵权请尽快告知,我们将会在第一时间删除。邮箱:2942802716#qq.com(#改为@)。
- 本站原创内容未经允许不得转载,转载请注明出处“站长百科”和原文地址。